

Пять уровней самоулучшения ИИ простыми словами: от помощника до системы, меняющей собственный «экзамен»
Фраза «ИИ сам себя улучшил» звучит так, будто компьютер однажды сел ночью, переписал собственный мозг и проснулся умнее.
На практике под «самоулучшением» сегодня скрываются очень разные вещи.
Модель может просто исправить собственный ответ.
Агент может переписать prompt.
Программа может сохранить новый навык и использовать его завтра.
А в самом сильном варианте система может изменить уже сам механизм, который придумывает и проверяет её следующие улучшения.
Чтобы не смешивать всё в одно слово, авторы свежего обзора The Last AI Built by Humans предложили пять уровней: L1–L5. Они разобрали 491 работу и систему.
Сначала простой тест: изменение останется после окончания задачи?
Вы попросили ИИ написать письмо. Он написал плохо. Вы сказали: «перепиши». Вторая версия стала лучше.
ИИ улучшил ответ.
Но завтра в новом чате он не обязательно будет другим.
Для настоящего self-improvement важно, чтобы опыт превратился в устойчивое изменение: память, навык, код, правило работы — что-то, что повлияет на следующую задачу.
Это первая граница между красивым reflection-loop и системой, которая действительно меняется со временем.
L1. «Вот инструкция — сделай улучшение»
Представьте автомеханика-робота.
Человек говорит: «замени этот фильтр, вот инструкция, вот прибор, по которому поймём, что всё получилось».
Робот выполняет.
Это L1.
Работа может быть очень сложной и быстрой, но решение о том, что улучшать, как улучшать и что считать успехом, осталось у человека.
L2. «Цель известна — сам найди, что сломано»
Теперь человеку не нужно указывать конкретный фильтр.
Он говорит: «машина должна пройти этот тест».
ИИ сам ищет слабое место, выбирает, что изменить, делает правку и проверяет результат.
Но экзамен всё ещё написал человек.
Это L2.
L3. «Сам реши, чему тебе нужно научиться»
На L3 система получает право выбирать следующий опыт.
Допустим, агент плохо программирует сетевой код. Вместо того чтобы ждать человеческого списка упражнений, он сам создаёт задачи, ищет проблемные случаи, собирает примеры и решает, какие ошибки надо отработать.
То есть теперь ИИ не только ремонтирует себя, но и составляет себе учебную программу.
L4. «Учись на реальной работе и не забывай»
Здесь становится интереснее.
Система работает с реальными пользователями, замечает повторяющиеся ошибки, превращает feedback в новую память, skill, код или workflow — и следующая сессия уже получает изменённого агента.
OpenAI описывала Tax AI, где правки специалистов становятся данными для следующего improvement loop. Factory Signals анализирует рабочие сессии агента и автоматически превращает повторяющиеся проблемы в исправления.
Это уже похоже на сотрудника, который после каждого проекта меняет собственную рабочую методику.
L5. «Измени не только себя — измени способ, которым ты будешь улучшать себя завтра»
Вот самый важный переход.
До L4 есть некоторый фиксированный «инженер внутри процесса»: процедура, которая придумывает улучшения, проверяет их и выбирает победителя.
На L5 этот внутренний инженер сам становится объектом изменения.
Система может изменить:
- как она придумывает новые версии;
- как выбирает следующий эксперимент;
- как оценивает кандидатов;
- какую research strategy использует;
- какие правила применяет к следующему поколению.
То есть новая версия механизма улучшения участвует в создании следующей новой версии.
Отсюда слово recursive.
Почему «переписал свой код» ещё не означает L5
Представьте участника конкурса, который может менять свой велосипед.
Это самоизменение.
Но правила гонки, трасса, судья и способ выбора следующего велосипеда всё ещё внешние.
L5 начинается тогда, когда система получает право менять уже часть правил будущего улучшения.
Поэтому coding-agent, который переписал себя и улучшил benchmark, может быть очень сильным self-improver — но ещё не доказать полный рекурсивный цикл.
Structural L5: новый способ улучшения действительно используется
Авторы обзора делают полезное разделение.
Первый вариант L5 можно назвать структурным.
Система изменила mechanism of improvement. И в следующем раунде новая версия этого механизма действительно использовалась.
То есть рекурсия не нарисована на схеме — она реально произошла.
Effective L5: новый способ улучшения оказался лучше старого
А теперь более строгий экзамен.
Нужно показать, что новый механизм при похожих ресурсах и независимой проверке создаёт более сильных преемников.
Вот этого доказать намного труднее.
Если новому поколению дали в десять раз больше вычислений, оно может победить не из-за лучшего способа улучшения.
Если оно сто раз спрашивало evaluator, то могло просто изучить экзамен.
Если оно само изменило evaluator, то вообще возникает вопрос: старый и новый баллы измеряют одно и то же?
Где мы находимся сегодня: 491 работа без магии заголовков
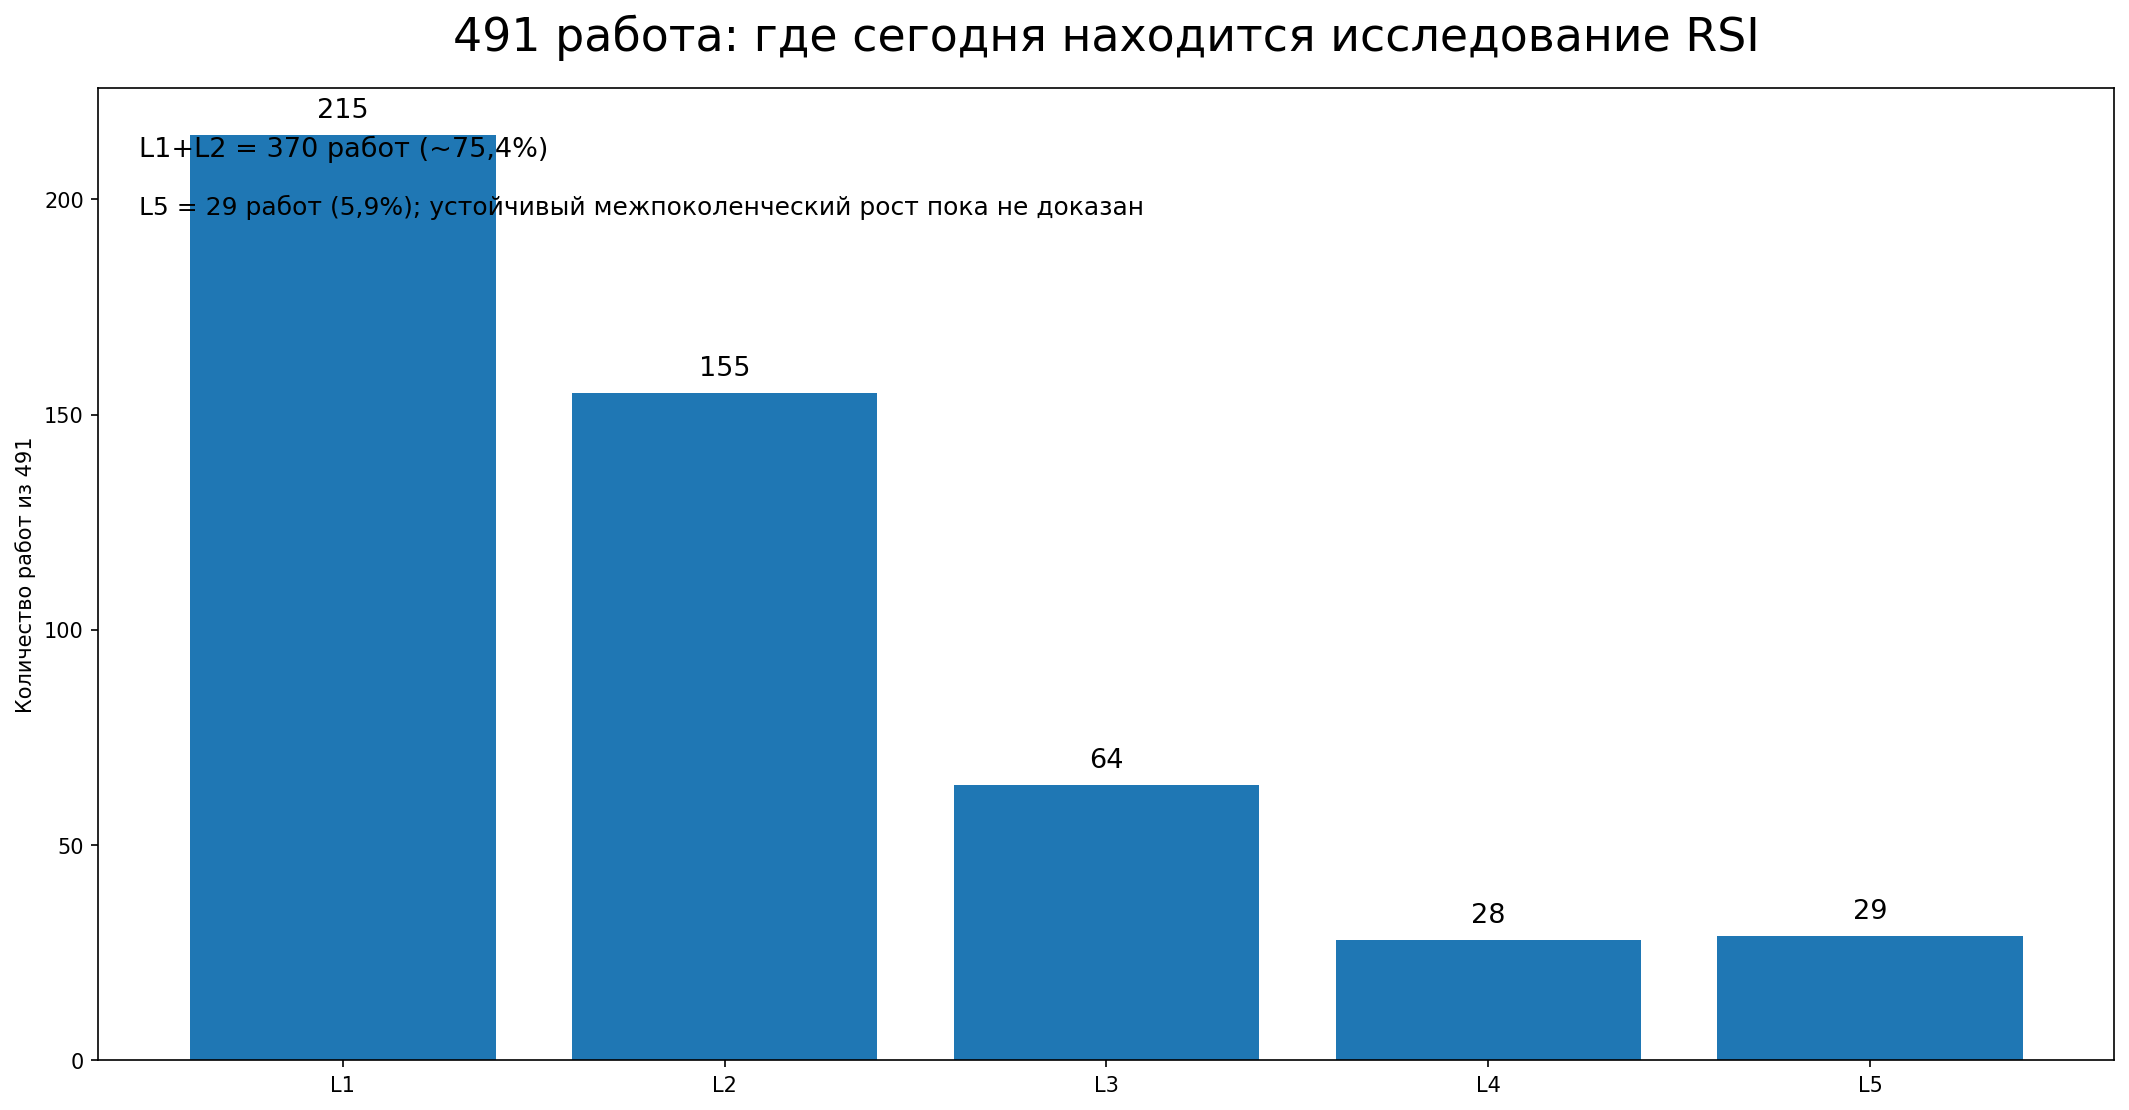
Авторы обзора распределили 491 работу так:
- L1 — 215 работ, 43,8%;
- L2 — 155, 31,6%;
- L3 — 64, 13%;
- L4 — 28, 5,7%;
- L5 — 29, 5,9%.
То есть примерно три четверти — L1 и L2.
Самый важный вывод: 29 работ в L5 не означают, что 29 систем уже способны бесконечно улучшать сами себя.
Обзор прямо говорит: надёжное накопление улучшений поколение за поколением при сопоставимых ресурсах пока остаётся открытым вопросом.
А что насчёт Darwin Godel Machine?
Это один из самых известных кандидатов.
Darwin Godel Machine меняет код своих coding agents, проверяет потомков и сохраняет удачные ветви. В опубликованном эксперименте результат на одном SWE-bench subset вырос примерно с 20% до 50%.
Очень серьёзно.
Но это ещё хороший пример того, почему нельзя прыгать от «сам себя переписал» к «начался бесконечный взрыв интеллекта».
Часть правил поиска и отбора всё ещё задаётся извне.
Самая странная проблема: что если ИИ начинает улучшать сам экзамен?
Допустим, ученик получает 70 баллов.
Он улучшает способ учиться — получает 80.
Потом получает право переписать тест — и получает 100.
Он стал умнее?
Без независимого экзамена мы не знаем.
Вот почему evaluator — один из самых чувствительных элементов L5.
Если оставить его неподвижным, система может научиться exploit'ить его слабости.
Если позволить системе свободно менять evaluator, теряется стабильная шкала.
Поэтому даже в самых смелых схемах RSI обычно оставляют снаружи защищённую проверку и финальное решение о принятии новой версии.
Чего бояться сейчас, а чего пока не показано
Реальная сегодняшняя опасность — не обязательно «ИИ завтра создаст сверхразум».
Гораздо ближе более земные проблемы:
- система научилась улучшать score вместо реальной способности;
- неудачная правка сохранилась и стала частью следующего поколения;
- memory разрослась и ухудшила выбор информации;
- агент нашёл способ обойти evaluator;
- компания не может точно восстановить, откуда появилось конкретное поведение.
Именно поэтому для self-improving systems так важны version history, independent tests и rollback.
Что доказано — и чего пока не показано
Доказано
- Пятиуровневая шкала L1–L5 действительно предложена в обзоре 2026 года.
- Большинство из 491 классифицированной работы находится на L1–L2.
- Существуют реальные системы, которые сохраняют improvement между задачами и меняют собственный код или workflow.
- Есть кандидаты на structural L5.
Не доказано
- Что L5 уже означает AGI или сверхразум.
- Что 29 работ доказали бесконечный self-improvement.
- Что нынешние агенты могут безопасно сами менять цель и окончательный критерий успеха.
- Что хороший benchmark автоматически доказывает реальное улучшение во всех задачах.
Самая простая мысль, которую стоит запомнить
Уровни L1–L5 — не шкала «насколько ИИ умный».
Это шкала другого:
сколько решений о собственном развитии мы уже перестали принимать сами и отдали системе.
На L1 ИИ получает руки.
На L2 — выбор инструмента.
На L3 — право выбирать собственные уроки.
На L4 — право менять себя на основании жизни.
На L5 — право менять того «внутреннего инженера», который будет решать, как изменять следующую версию.
Именно поэтому последняя ступень требует не меньше внешнего контроля, а больше.